1. A propos du cours
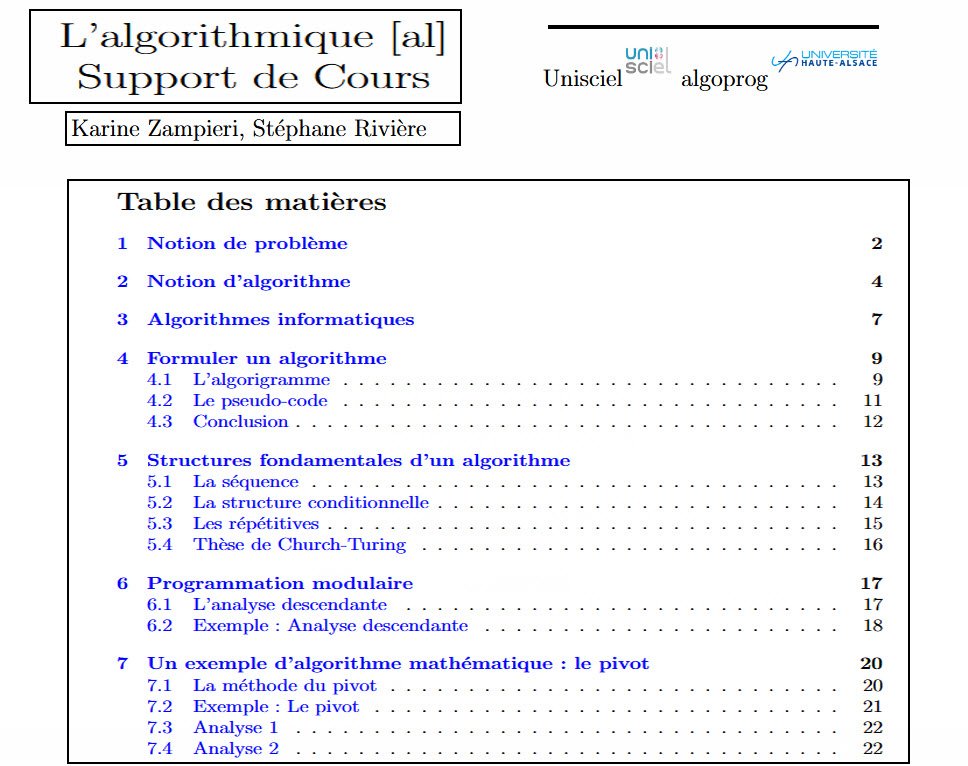
- Auteurs : Karine Zampieri et Stéphane Rivière
- Type : Support de cours d’introduction à l’algorithmique – Unisciel algoprog, version du 12 mai 2018
- Langue : Français
- Licence : Non précisée explicitement dans le document PDF
2. Prérequis
- Aucun prérequis avancé en algorithmique n’est nécessaire, le document étant un module introductif destiné à présenter et justifier les grands concepts utilisés dans la suite du cours.
- Posséder des notions générales en informatique permet de mieux comprendre la relation entre algorithme, programme et ordinateur.
- Des connaissances élémentaires en mathématiques sont utiles pour suivre l’exemple final consacré à la résolution d’un système d’équations par la méthode du pivot de Gauss.
- Une connaissance préalable d’un langage de programmation n’est pas indispensable puisque le cours insiste d’abord sur la logique de résolution indépendamment des détails syntaxiques d’un langage.
- Une familiarité avec les notions de données, résultats, opérations et conditions facilite la compréhension du pseudo-code présenté dans le document.
3. Publique cible
Ce cours s’adresse principalement aux étudiants, débutants en informatique et apprenants souhaitant comprendre les fondements de l’algorithmique avant l’étude d’un langage de programmation. Il convient également aux enseignants recherchant un support introductif sur les problèmes, algorithmes, pseudo-code, structures de contrôle et méthodes de conception modulaire.
4. Outils matériels et logiciels
4.1 Outils matériels
- Un ordinateur de bureau ou portable pour consulter le support et expérimenter ultérieurement les algorithmes dans un langage de programmation.
- Aucun matériel spécialisé n’est nécessaire, le cours étant principalement consacré aux principes théoriques et méthodologiques de l’algorithmique.
- Une connexion Internet est utile pour consulter les ressources Unisciel algoprog et les références complémentaires proposées à la fin du document.
4.2 Outils logiciels
- Un navigateur Web ou un lecteur PDF permettant de consulter le support de cours.
- Un éditeur de texte peut être utilisé pour rédiger et expérimenter les algorithmes en pseudo-code.
- Un langage de programmation impératif peut être utilisé pour traduire les algorithmes étudiés ; le document cite notamment C/C++, Java et Python.
- Un environnement de développement adapté au langage choisi peut être utilisé dans un second temps pour transformer les algorithmes en programmes exécutables.
5. Champs d'applications
- Apprentissage des fondements de l’algorithmique.
- Analyse et spécification d’un problème avant sa résolution informatique.
- Conception d’algorithmes informatiques indépendants d’un langage de programmation particulier.
- Représentation graphique d’un algorithme à l’aide d’un algorigramme.
- Représentation textuelle des solutions avec le pseudo-code.
- Utilisation des trois structures fondamentales : séquence, structure conditionnelle et répétition.
- Prévention des boucles infinies grâce à une formulation correcte des conditions d’arrêt.
- Compréhension de la thèse de Church-Turing dans le cadre des structures fondamentales présentées.
- Conception de programmes selon les principes de la programmation modulaire.
- Décomposition d’un problème complexe en sous-problèmes par analyse descendante.
- Amélioration de la compréhension, de la testabilité et de la réutilisabilité des solutions.
- Préparation à la programmation structurée et procédurale.
- Préparation à l’étude des tableaux, fichiers, structures de données, récursivité et programmation orientée objet.
- Application de la démarche algorithmique à des problèmes mathématiques tels que la méthode du pivot de Gauss.
6. Courte description
Ce support introduit les fondements de l’algorithmique : formulation d’un problème, définition et propriétés d’un algorithme, algorigramme, pseudo-code, séquences, conditions, répétitions et programmation modulaire. Il développe ensuite la méthode d’analyse descendante à travers un exemple complet fondé sur le pivot de Gauss.
7. Longue description du cours
Le support L’algorithmique d’Unisciel algoprog constitue une introduction méthodologique aux principes fondamentaux nécessaires à la conception de programmes informatiques. Le document ne commence volontairement pas par la syntaxe d’un langage de programmation particulier : il cherche d’abord à expliquer comment passer d’un problème à une méthode de résolution suffisamment précise pour pouvoir ensuite être traduite en programme. Cette démarche place donc l’algorithmique en amont de l’apprentissage des langages de programmation.
La première partie est consacrée à la notion de problème. Le cours rappelle que l’ordinateur constitue une machine particulièrement intéressante parce qu’il peut effectuer rapidement et avec régularité des tâches nécessaires à la résolution de problèmes. Toutefois, avant de demander à une machine d’effectuer un traitement, il est indispensable de déterminer précisément le problème à résoudre. Un problème correctement posé doit identifier les données disponibles, l’objectif à atteindre, les hypothèses et la situation initiale. Le document résume cette démarche par une formulation du type : étant donné certaines données, on demande d’atteindre un objectif déterminé.
Une fois le problème correctement défini, le cours introduit la notion d’algorithme. L’algorithmique consiste à expliquer à une personne ou à une machine disposant d’un nombre limité d’opérations élémentaires comment atteindre un résultat en lui indiquant les étapes nécessaires. Pour rendre cette notion intuitive, le document utilise plusieurs exemples issus de la vie courante : notice de montage, utilisation d’une cafetière, modèle de tricot, recette de cuisine ou multiplication de nombres. Ces situations ont en commun l’existence de données initiales, d’une suite d’étapes et d’un résultat attendu.
Un algorithme est présenté comme une spécification d’un schéma de calcul constituée d’une suite finie d’opérations élémentaires organisées selon un enchaînement déterminé afin de parvenir à un résultat. Il possède notamment un nom, des données, un ou plusieurs résultats et une succession chronologique d’étapes ou de sous-algorithmes agissant sur les données. Des commentaires peuvent également accompagner certaines étapes afin d’expliquer le raisonnement suivi.
Le document insiste particulièrement sur la nécessité d’utiliser des opérations bien définies. Une instruction dépendant de l’appréciation personnelle de l’exécutant risque de produire des résultats différents d’une exécution à l’autre et devient difficile, voire impossible, à traduire dans un langage informatique. Une opération est donc considérée comme correctement définie lorsque son résultat est entièrement prévisible.
À partir de ces considérations, le cours fournit une définition plus complète : un algorithme est un processus de calcul non ambigu, déterministe et fini, exprimé à l’aide d’instructions élémentaires exécutables et, si possible, efficace. Il doit atteindre l’objectif pour lequel il a été conçu quelles que soient les valeurs admissibles des données. Les propriétés essentielles retenues sont ainsi la non-ambiguïté, le déterminisme, la précision des étapes élémentaires et la finitude.
Le cours précise également que l’algorithmique est l’étude formelle des algorithmes et qu’elle s’intéresse notamment à leur complexité, c’est-à-dire à une mesure théorique de leurs performances indépendamment d’un environnement matériel ou logiciel particulier. Cette remarque introduit dès le début l’idée qu’un bon algorithme ne doit pas seulement produire le bon résultat : son efficacité constitue également un critère important.
La partie suivante introduit les algorithmes informatiques. Un algorithme informatique est défini comme une procédure de résolution d’un problème contenant des opérations bien définies sur des informations, organisée sans ambiguïté et destinée à être traduite dans un langage de programmation. Le document établit alors clairement la distinction entre algorithme et programme : le programme représente l’algorithme dans un langage technique compris par l’ordinateur, comme C/C++, Java ou Python.
Cette distinction conduit à une conséquence essentielle : puisque le programme est la représentation d’un algorithme, il est nécessaire de concevoir d’abord un algorithme correct pour espérer obtenir un programme correct. La correction du programme dépend donc à la fois de la logique de résolution et de la maîtrise de la syntaxe du langage de programmation choisi. Le document rappelle également qu’un algorithme reste indépendant du langage dans lequel il sera implanté et de la machine qui exécutera finalement le programme.
La section consacrée à la formulation d’un algorithme explique qu’au moment de la conception, le développeur doit se concentrer sur la logique de résolution sans être perturbé par les détails propres aux langages de programmation. Deux moyens de représentation sont étudiés : l’algorigramme et le pseudo-code.
L’algorigramme, également appelé organigramme de programmation ou logigramme, constitue une représentation graphique d’un algorithme. Les traitements et affectations peuvent être représentés par des rectangles, les décisions par des losanges et les flèches indiquent l’enchaînement des opérations et des entrées-sorties. Le document illustre progressivement ce formalisme à travers un exemple de recherche d’un partenaire pour danser, ce qui permet également d’aborder la question de la terminaison et de l’efficacité d’un algorithme.
Le pseudo-code, ou langage algorithmique, constitue pour sa part une représentation textuelle. Il est également désigné comme Langage de Description des Algorithmes. Ce langage formel et symbolique utilise des noms représentant les objets manipulés, des mots-clés et des opérateurs traduisant les opérations pouvant être exécutées. Le cours le présente comme étant à la base des langages de programmation impératifs.
Le pseudo-code doit trouver un équilibre entre lisibilité et formalisme. Il est destiné à un lecteur humain et non directement à un compilateur ; il doit donc être compris sans ambiguïté tout en évitant une rigidité excessive. Le document présente l’algorithme général exprimé en pseudo-code comme un niveau intermédiaire entre une description globale en langage naturel ou sous forme d’algorigramme et le programme finalement exprimé dans un langage informatique.
Le cours étudie ensuite les trois structures fondamentales d’un algorithme. La première est la séquence : les opérations sont exécutées successivement, une seule fois, dans l’ordre où elles apparaissent. Cette structure correspond au déroulement linéaire le plus simple d’un traitement.
La deuxième est la structure conditionnelle. Elle permet de décider si une opération ou un groupe d’opérations doit être exécuté en fonction de la valeur d’une condition. L’exemple culinaire du document montre comment une même opération générale peut être détaillée différemment selon que l’on dispose d’une cuisinière à gaz ou électrique. Le cours introduit également la notion de commentaire, qui explique la logique suivie sans faire partie des opérations réellement exécutées.
La troisième structure correspond aux répétitives. Le document distingue les répétitions inconditionnelles, dans lesquelles une opération est effectuée un nombre déterminé de fois, et les répétitions conditionnelles, exécutées tant qu’une condition est vérifiée ou jusqu’à ce qu’elle le devienne. Une attention particulière est accordée au risque de boucle infinie lorsque la condition d’arrêt est mal formulée ou impossible à atteindre.
Ces trois structures sont ensuite reliées dans le document à la thèse de Church-Turing : le support affirme que tout algorithme peut être décrit au moyen de la séquence, de la sélection Si et de la répétition TantQue. Il en tire comme conséquence qu’un langage de description algorithmique et, par extension, un langage de programmation doit contenir ces structures ou pouvoir s’y ramener. Les langages C/C++, Java et Python sont cités comme exemples dans ce cadre.
Une autre partie importante du cours est consacrée à la programmation modulaire et particulièrement à la méthode d’analyse descendante, ou top-down design. Cette méthode consiste à décomposer un problème en problèmes plus petits et plus élémentaires jusqu’à obtenir des opérations suffisamment simples pour pouvoir être exécutées directement.
Le processus d’analyse descendante comporte plusieurs étapes : décomposer le problème en sous-problèmes, déterminer pour chacun les données d’entrée et les résultats attendus, spécifier les moyens permettant de passer des entrées aux résultats, vérifier le fonctionnement de chaque sous-problème, organiser leur ordre d’exécution, valider la solution finale puis éventuellement l’optimiser. Cette démarche permet de réduire progressivement la complexité du développement.
Le document souligne plusieurs avantages de cette méthode. La décomposition facilite la compréhension du code et sa testabilité. Elle conduit également naturellement à la modularité et favorise la réutilisabilité des modules. Une solution développée pour un problème peut ainsi servir de base à la résolution d’autres problèmes proches, ce qui évite de recommencer systématiquement tout le travail de conception.
Le niveau de décomposition dépend cependant du destinataire. Une opération parfaitement claire pour un spécialiste peut devoir être détaillée en plusieurs étapes pour un débutant et encore davantage pour une machine. Le cours illustre cette idée à travers une recette de cuisine décrite successivement pour un spécialiste, un cuisinier expérimenté, un débutant puis un ordinateur. Pour une machine, chaque opération doit finalement être décomposée jusqu’à atteindre des instructions suffisamment élémentaires pour être exécutables.
La dernière grande partie du document applique cette méthodologie à un problème mathématique plus élaboré : la méthode du pivot de Gauss utilisée pour résoudre un système de Cramer. Le principe consiste à transformer progressivement un système de n équations à n inconnues en un système triangulaire en éliminant successivement les inconnues. Une fois cette triangularisation réalisée, les inconnues peuvent être déterminées en remontant depuis la dernière équation.
Le choix du pivot constitue une étape essentielle de la méthode. Le document explique qu’il faut disposer d’un pivot non nul et qu’il est préférable, afin de limiter les erreurs de calcul, de choisir le coefficient ayant la plus grande valeur absolue parmi les candidats. Un exemple numérique à trois équations montre concrètement les différentes étapes d’élimination et conduit à une solution déterminée.
L’intérêt pédagogique de cet exemple réside surtout dans la mise en œuvre progressive de l’analyse descendante. Le problème est d’abord exprimé à un niveau général : entrer les données, triangulariser le système, résoudre puis sortir les résultats. Chacune de ces opérations est ensuite progressivement décomposée : rechercher un pivot, déplacer l’équation correspondante, éliminer une inconnue, calculer les valeurs des variables et afficher les résultats.
Les dernières étapes poursuivent ce raffinement jusqu’à obtenir uniquement des opérations directement exécutables par un ordinateur : affectations, parcours d’indices, sommes et produits de nombres réels, tests conditionnels et répétitions. L’exemple montre ainsi concrètement comment partir d’un problème mathématique relativement complexe et aboutir, par décompositions successives, à un ensemble d’instructions élémentaires pouvant être traduites dans un langage de programmation.
La conclusion replace ces notions dans la perspective générale du cours d’algorithmique. L’objectif est d’apprendre une bonne démarche d’élaboration d’algorithmes et de comprendre l’intérêt des méthodes et techniques classiques ayant déjà fait leurs preuves. Le résultat attendu est la production de programmes dont la correction peut être comprise et vérifiée plus facilement et dont la maintenance reste aussi aisée que possible.
Le document annonce enfin les domaines qui prolongent cette introduction : programmation structurée avec variables et structures de contrôle, programmation procédurale avec sous-programmes et passage de paramètres, traitement des tableaux et des fichiers séquentiels, programmation orientée objet, problèmes récursifs et manipulation de structures de données telles que les listes, files d’attente, piles, tables de hachage, arbres et graphes. Ce support constitue ainsi une introduction générale destinée à préparer méthodiquement l’apprentissage de la programmation et des algorithmes plus avancés.
8. Aperçu du document
Voir ou télécharger le document sur le site d’origine
Ce document est hébergé par une source externe. Nous ne revendiquons aucun droit sur son contenu. Pour toute demande de retrait, veuillez contacter l’auteur ou l’hébergeur officiel.